Agent 每一步的
判断层
不写答案,直接给出概率
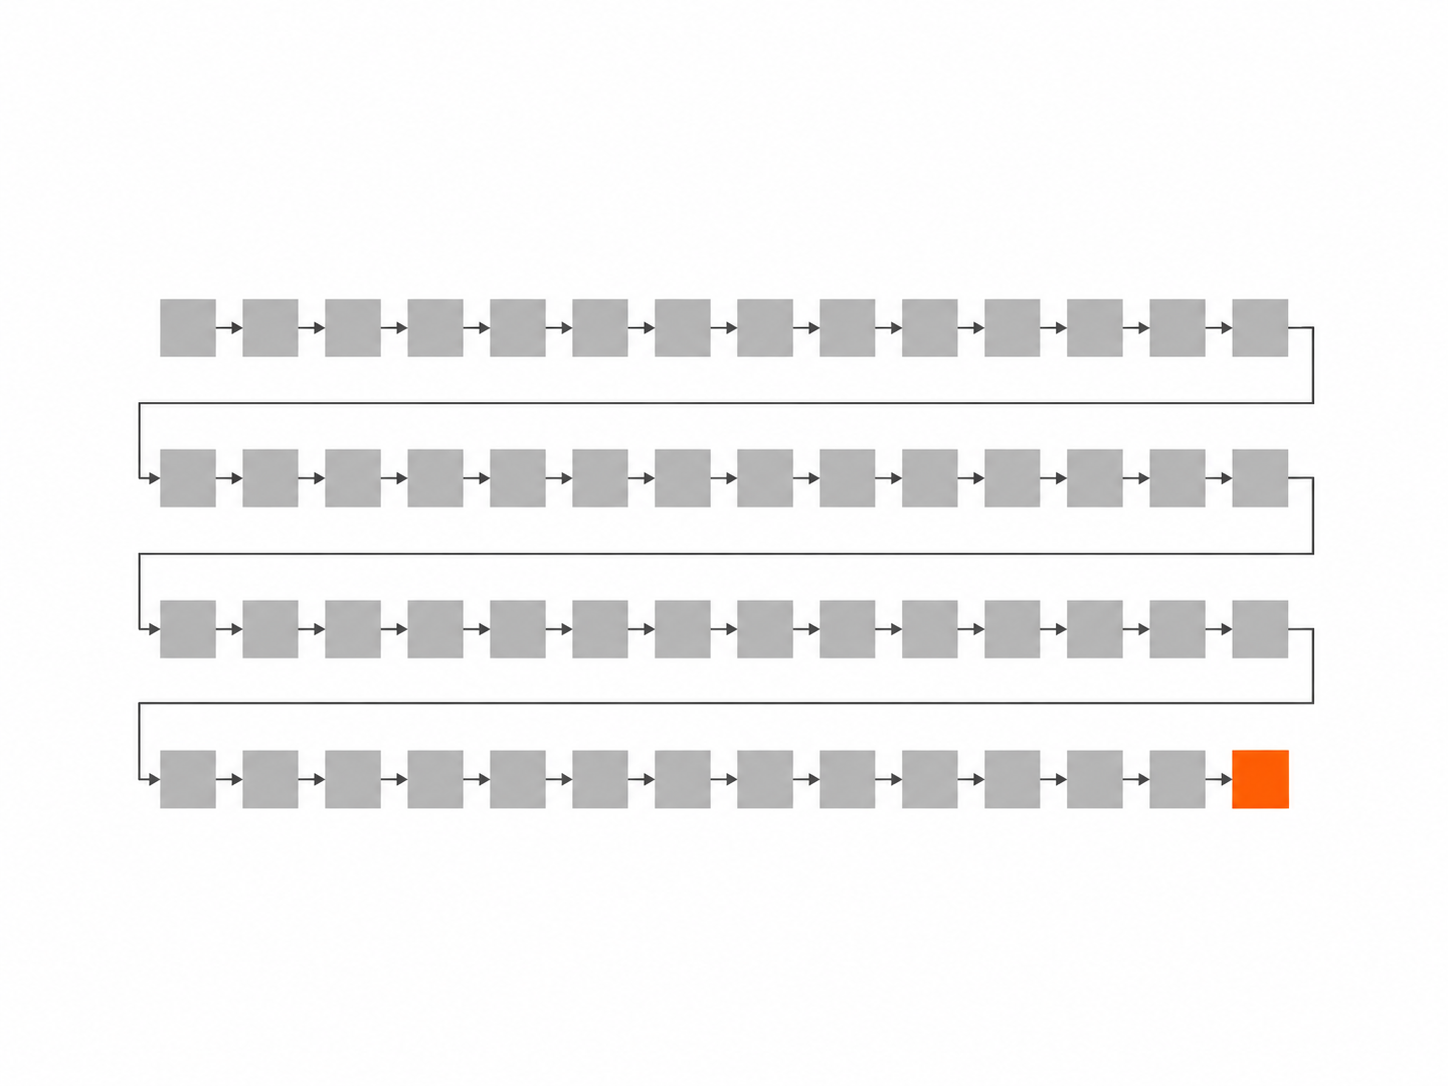
逐字生成再解析答案,太慢太贵,撑不起 Agent 的每一步。
- 依赖几十到几百个 token 线性解码
- 再经文本解析提取答案
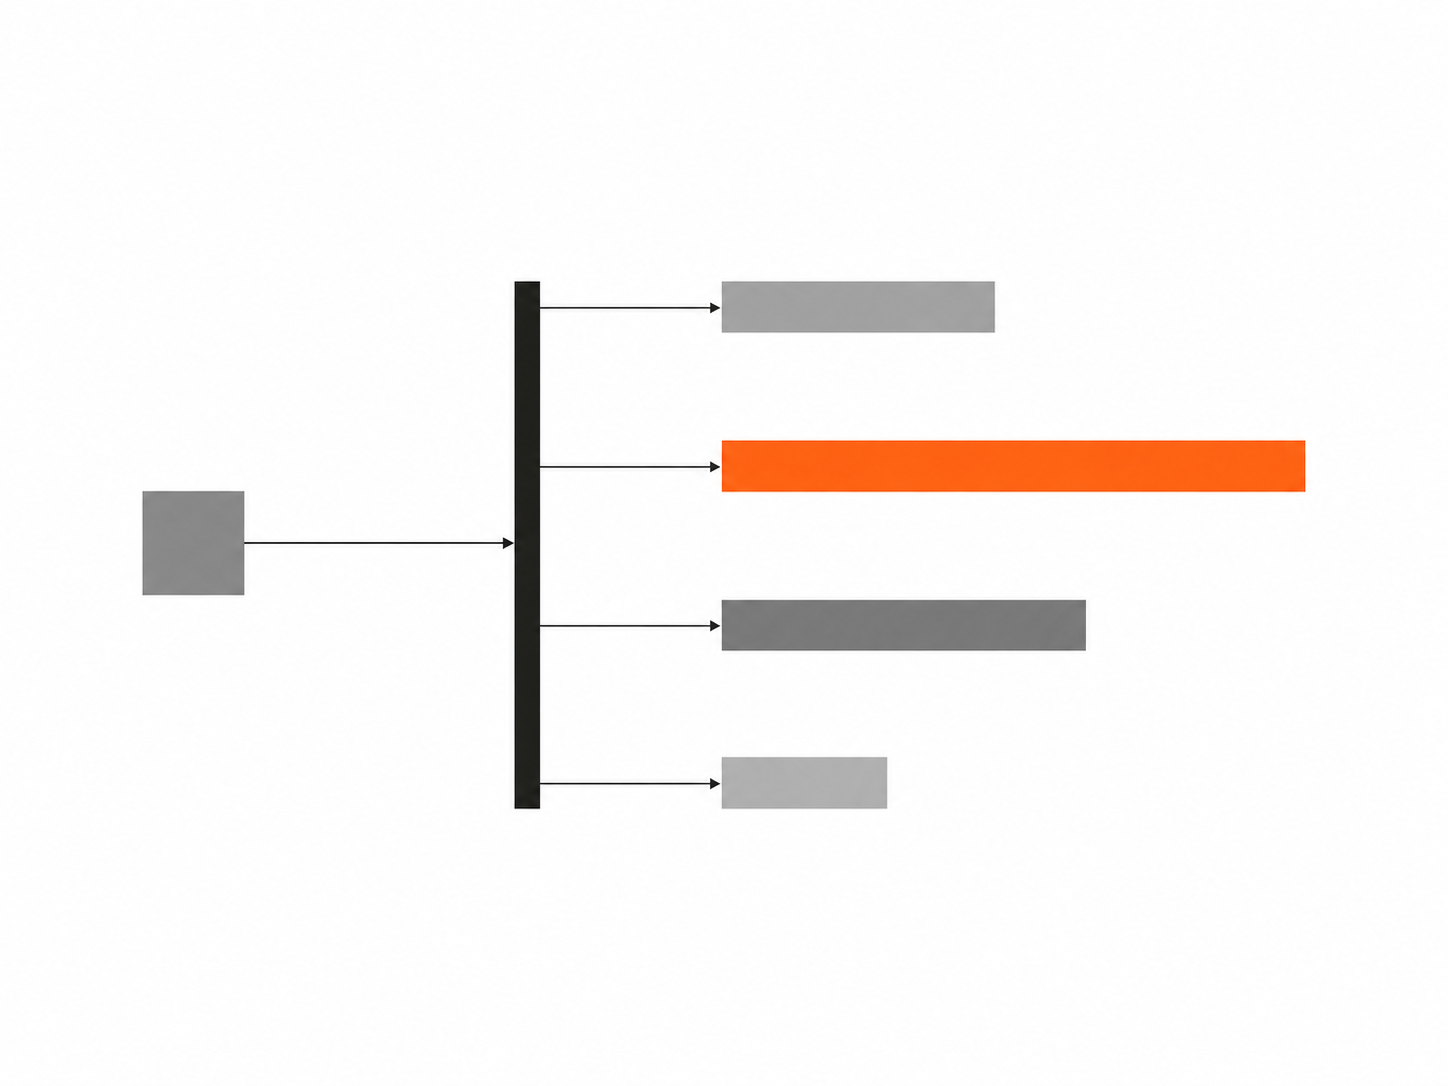
候选空间天然已知,单次前向直接计算各选项概率。
- 支持多问题共享输入并行判定
- 低置信度自动交由大模型或人工复核
凡是从已知选项里挑,
都能交给它
Agent 的大部分决定不需要写文章:这条结果能不能用、调哪个工具、这条消息转给谁。这些交给判断模型,大模型只做真正要生成的那一步。
是,还是否
用在:搜索结果筛选、理赔判定、合规检查
给每个候选打分
用在:Agent 搜索、工具路由、推荐
多个里选一个
用在:客服分流、语音助手、模型路由
Agent
每一步
都在选
搜哪条、用哪个工具、消息转给谁,今天都让最贵的大模型读完再选。结果:Agent 做不了更多事,每件事还更贵。
Agent 的能力被工具数量封顶——接不进长尾工具,就做不了复杂任务。
大量 token 花在读无用网页上,召回还不准——成本高、答案差,而且随查询量线性上涨。
同一个网页“好不好、能不能用”,每次查询都被重新判断一遍——全行业在为同一件事反复付费,搜索的单位成本降不下来。
Agent 用的每一层,
资本都在重注
Agent 每一步都在已知候选里挑一个:读哪条、调哪个、交给谁、拦不拦、记什么、接不接话。每一层都有独角兽或并购,我们卖的是每一层里的这次判断。
2026.05 · C 轮 $250M
a16z 领投
2026.06 · A 轮 $60M
8 月收购 Smithery
2026.05 · B 轮 $113M
CapitalG 领投
2025.07
被 Palo Alto 收购
2025.02
被 MongoDB 收购
2026.01 · C 轮 $130M
AVP 领投
今天 Agent 拿到搜索结果后,要让大模型自己读一遍,再判断哪几条能用。Arbiva 把这一步交给判断模型,召回就可以用最便宜的,质量靠判断补回来。
判断模型的第一个产品:
给 Agent 做搜索
一次搜索返回 10 条清洗后的正文摘录,约 3k–10k tokens。其中仍有导航文字和重复段落,也没有可信度、内容农场这类判断字段,哪几条能用,还得大模型自己读完再判断。
-
大模型(Opus 5)读完 10 条再判断$0.0501 万 tokens × $5 / 百万
-
Arbiva 判断模型判断同样 10 条$0.0004同一把尺子上只有约 1/119
现在 · 便宜召回+判断
我们不爬全网:接 Parallel 这类 $1 / 千次的召回,判断模型挑出能答全的最少几条。已跑通。
接着 · 高频领域自建索引
文档、代码、价格、新闻先建。入库时逐页判断一次,存成结构化字段。
长尾 · 按需抓取
判断“没有一条能答全”时当场抓取、写回索引。抓取预算跟着需求走。
少读 70% token,账单省近一半
Agent 搜一次网页,搜索 API 返回 10 条。今天常见做法是用 Exa,10 条全部塞给大模型。Arbiva 换用便宜 7 倍的召回源,再让判断模型挑出合起来能把问题答全的几条;按 $5 / 千次收费,客户的大模型少读的部分就是省下的钱。判断这一步暂由 Jev 代跑。
索引里多存一层判断
判断只做一次,查询越多分摊越低。
Exa API 怎么收费?
每次查询都重读全部网页
Exa API 怎么收费?
先按标签筛掉 6 页,大模型只读剩下 2 页(示意)
10 亿网页判断一遍的推理费(爬取、存储另计):每页约 2,500 token,按自有推理实测 $0.011 / 百万 token
来源、可信度、时效与问题无关,入库判一次;能否答全这道题,查询时只对过滤后的几页判
同一份判断接着用于意图排序(第 14 页)
工具再多,大模型只读 3 个
Agent 每一步都要选工具,一个任务几十步。Monid 把 2,000+ 工具收进一个目录,挑哪个仍靠 Agent 自己读;我们把“挑”做成一次判断。
先判断这一步属于哪一类:搜索、写代码、查数据库、发消息……
类里的每个工具逐一打分,一次判完。
大模型只读这 3 个工具的说明,上下文不再被工具列表撑爆。
TypeSafe 官方示例用同样的“先广筛、再细读前三”:182 个技能里,选错率从 16.8% 降到 7.3%。来源:TypeSafe · Skill suggestion
换一组问题,
就是下一个 API
搜索和工具路由之后,同一个判断模型接着卖给其他 Agent 判断、客服、物流、语音。后三类的依据常是截图、照片和录音,正是我们和 Jev 拉开差距的地方(第 12 页)。
护栏、记忆、模型路由
每步都可能要判:输入里有没有注入、该取哪条记忆、交给大模型还是小模型。
和工具路由同一个接口,已接入的客户换一组问题即可。
分流、退款、合规
每条消息 3–5 次:转哪个部门、多急、能否直接退款、回复合不合规。
工单常带截图、录音和几十轮历史,Jev 看不了图、装不下长工单。
签收、破损、退货
每件包裹每个节点一次:揽收、中转、签收、退货申请。
依据是照片。今天要先调视觉模型转文字再判;我们的模型原生支持看图,评测中。
该谁说话、要做什么
每秒数次:用户说完了没有、要不要插话、这句话对应哪个动作。
模型原生支持音频,可省掉先转写再判的延迟,评测中。
从排序到行动
搜索是人找信息,推荐是从过去猜你;下一代是你说出此刻的需求,判断层当场排序。同一个快判断,也能替机器人选下一步。
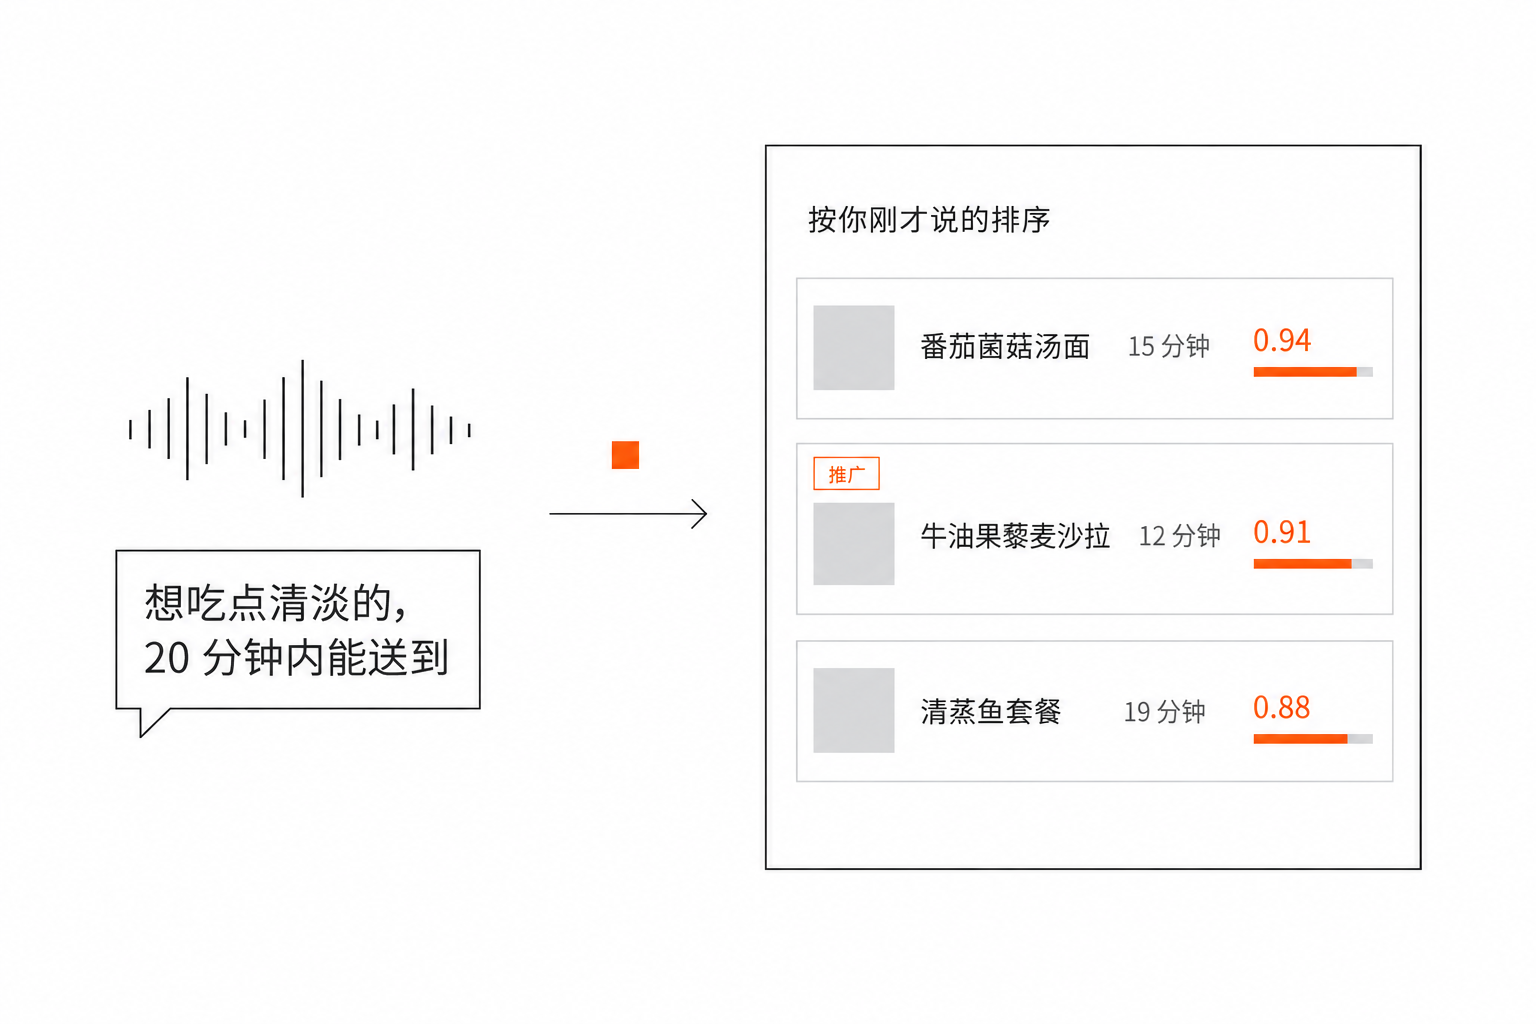
不用再一屏屏地刷:一句话需求,当场给出排好序的结果,推广也按这句话匹配。
来源:WPP Media · This Year Next Year 2026 年中预测
更便宜、看得见图、
装得下长上下文
Jev 验证了判断模型这个品类。我们在同一个品类里,从成本、模态和上下文三处拉开差距。
从模型到产品全链路自研
判断模型
强化学习后训练,直接输出候选及概率,不生成思维链。
中文证据判断准确率 81.2%,超 Jev 4.3 个百分点(第 12 页)
专有推理引擎
专为判断重构:只做一次前向、不生成 token;低精度计算内核在建,继续压低单次判断成本。
现成推理已比 Jev 售价低 3.8 倍;自研引擎目标 10 倍
两层判断路由
先选类目,再精准锁定类内前 3 个工具,只把这 3 个交给大模型。
选错率 16.8% → 7.3%(第 9 页)
搜索 API+工具路由 API
MCP / CLI / API 全形态交付,
按调用量计费。
搜索 demo:盲测少读 70% token,同召回账单省近一半(第 7 页)
从 Agent 的搜索,到世界的排序
- 第 1 个月上线即收费
- 第 2 个月自研判断模型上线
- 第 3 个月付费规模化
- 工具路由按次收费
- 同一批客户,调用随步数涨
- 护栏、记忆、模型路由
- 客服、物流、语音付费
- 大客户签年度合同
- 高频领域自建判断索引
- 判断索引复用为排序
- 电商、内容平台试点
- 第 18 个月融 A 轮
广告、推荐、搜索
按此刻意图重排
每一帧判断下一步
慢系统想,快系统接
- 广告盘只是下限
- 按效果分成
懂 Agent 工具,带过团队,做过投资
- Apache Maka(孵化中)PPMC 成员、提交者ASF 首个 AI Agent 运行时项目,5,040 星;合并 959 个 PR,搭建了项目大部分评测设施(多 harness 公平对比,5 份公开报告)。2026.03 提交第一个 PR,半年进入 PPMC。
- OpenCLI 核心贡献者2.9 万星、合并 65 个 PR。OpenCLI 就是 Agent 调工具的典型:把网站和应用变成 Agent 能调的命令。
- 宠物食品品牌创始人兼 CEO,5 年2021–2026,管理团队 30 人。
- 投资加华资本投资经理;哔哩哔哩战略投资。新南威尔士大学本科、硕士。
- 在 Arbiva 已做中文证据判断 RL 后训练(超 Jev 4.3 个百分点)、搜索盲测、本 BP 全部 demo。
$1,000 万
覆盖 24 个月运营,另留约 10 个月储备
搜索实测毛利约 70%
- $160 万
团队
上海核心团队 3–4 人,模型、推理、搜索全自研,AI Agent 协同提效
- $200 万
判断模型
租用算力做蒸馏与 RL,数据与评测;多模态及 128K 分批投入
- $150 万
召回与推理
外采召回,推理按量弹性扩容;随调用量增长
- $110 万
获客
开发者生态、企业付费试点与试用额度,按转化追加
- $30 万
法务与合规
合同、数据许可、隐私安全与财务审计
- $350 万
战略储备
应对技术迭代与市场波动,不用于扩编
资金节奏:月均约 $27 万(前 12 个月约 $20 万,后 12 个月约 $34 万),收入持续冲抵消耗
行业对标:热门 AI 种子轮 $1,000 万、投后 $4,000–4,500 万(TechCrunch);AI 公司 A 轮门槛约 $350 万 ARR(Carta)